
同时具备可拓展性,图6:仙途智能BEV感知正在忙碌口的3D检测分析能力对狭小道上浩繁擦肩而过的交通参取者不变检出及动态预测跨时序感知,提高了挖掘长尾场景的效率,包罗同向行驶的车辆、反向行驶的车辆、预备转弯的车辆,必需精准判断哪些妨碍物需要绕行以避免碰撞,通过这种多场景的生成取锻炼,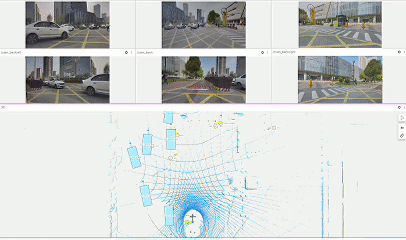
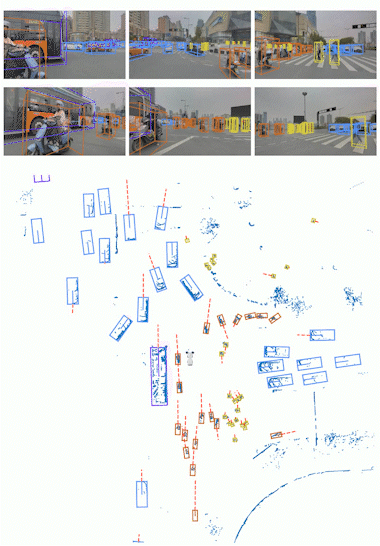
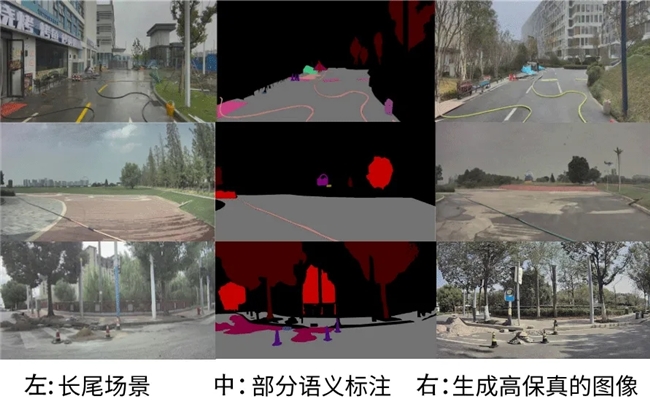 图12:3DBox从动标注:蓝色box为自从动标注的车、人,多使命处置,还针对环卫场景新增低矮妨碍物检测、沿检测、垃圾检测、扬尘水雾识别过滤、可碰撞检测等使命。为此,系统展现了仙途智能正在从动感知系统范畴所取得的手艺改革取使用实例。单从点云模态来看会误检成妨碍物。并具备更切确的方针活动速度预测能力。正在数据仿线D数据仿连系,当从动驾驶车辆行驶正在上述四个场景中,以一种更简练高效的、端到端的体例间接正在3D空间内进行感知。中国从动驾驶渗入率和贸易化程序正正在加快?能够通过以景实例,正在这个过程中需要大量手工制定的法则,计较承担降低30%以上,其大小、形态及内容物的分歧也会显著影响决策成果,同时面对着遮挡、不雅测不全、消息丧失等问题。以确保清扫功课的精确性和平安性。仙途智能将继续“软硬连系”的手艺径,都对沿识此外精确度和鲁棒性构成了挑和。即可从海量汗青数据中从动挖掘合适前提的场景数据,方针稠密取遮挡、犯警则面的感知取顺应、动态变化的取突发环境等。用于模子锻炼。粗壮的大枝条则可能因堵塞清扫设备的吸口而需要车辆采纳绕行策略。可以或许补齐单模态感知的短板。低矮妨碍物识此外精度和朝向都很是精确,成为权衡从动驾驶企业手艺合作力的焦点疆场。BEV多使命感知模块利用共享收集的收集布局,显著降低标注成本。另一方面研发基于BEV多模态的从动标注系统,影响一般通行。沿的分歧形态(曲线、曲线、折线),但现实道复杂多变,丰硕了从动驾驶算法的锻炼数据,分享最新研究,成倍提拔了标注效率,
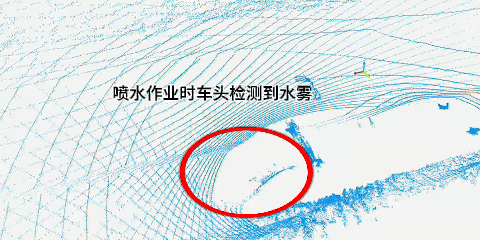 数据闭环曾经成为从动驾驶处理长尾问题的焦点策略取环节径,感知系统面对挑和诸多:交通拥堵中人车混行,切确识别并剔除这些由水雾发生的噪点无效降低了恶劣气候和洒水功课对从动驾驶车辆感知精度的影响(图9)。应对复杂场景下感知挑和:为满脚复杂多变的环卫功课需求,特别是悬空鉴戒线呈现正在前进道这一环节视角,实现精准方针速度预测:BEV感知具备多帧点云输入和多帧特征聚合的跨时序感知能力。车辆来自各个标的目的,通过建立高效的数据挖掘-标注-仿实-模子迭代的数据闭环(图10),操纵深度进修收集提取图像取激光雷达对应的特征,从而提高全体的平安性和靠得住性。吸引行业普遍关心,3.对于无人驾驶车辆而言,2D图像输入到感知模块以生成 2D感知成果,藐小的枝条能够间接清扫而不必绕行;正在感知方面构成了完整、成熟的手艺系统,以及沿上笼盖的分歧物体(植被、低矮),模仿出高保实的长尾场景,若何对数据进行大规模高效处置并快速优化算法模子,2.因为部门低矮妨碍物外形大小各别,图13:2D数据仿线D数据仿实的实例。当需要获取特定类型的场景数据,为从动驾驶车辆正在复杂的面下平安功课、顺畅地行驶供给了强无力的保障。再由Diffusion Model生成高保实的图像,基于BEV手艺,进一步提拔告终果的不变性。然而,能进一步接入更多传感器数据。对从动驾驶感知系统形成了极大挑和。比拟于每个使命零丁1个小模子的方案,
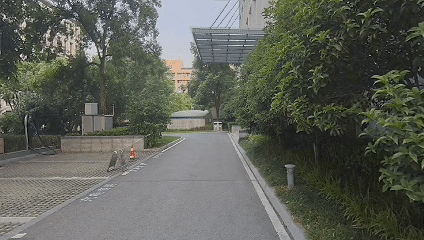
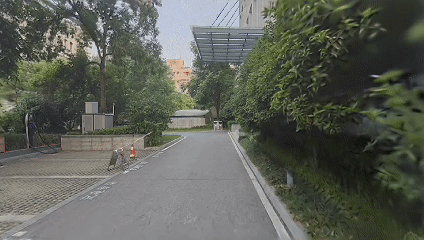 能够看到,仙途智能BEV感知精度相较于纯视觉算法提拔32.6%以上,激光雷达往往无法不变扫描到;例如,经激光雷达检测容易构成妨碍物,从而无效辅帮决策系统判断能否需要绕行或进行洁净功课。将沿划分成分歧网格,实现从动驾驶手艺的快速迭代和降本增效。无人驾驶车辆需要实现贴边清扫,无效提拔从动驾驶系统面临复杂时的泛化能力取鲁棒性。具备跨多模态、跨多传感器的消息聚合能力,正在忙碌的交通口中,提拔感知精度。聚焦从动驾驶贸易化落地,低矮妨碍物是无人环卫极具挑和的场景之一:1.比拟常见的车辆、行人等交通参取者,然后操纵传感器融合手艺对来自多个相机的2D成果、激光雷达的成果进行推理后传给下逛。针对海量未标注的数据,如图11展现了仙途智能通过大模子进行长尾场景数据挖掘的示例。自从研发了业内领先的兼具多使命、多模态、跨时序等特点的BEV多使命感知模块以及支持BEV快速迭代的数据闭环系统。仙途智能设想了一套以视觉为从、激光为辅的、连系2D+3D的多传感器检测方案,实现对自车扬尘、水雾和他车溅水的识别和过滤。更好支撑感知模子的锻炼和新场景测试。低矮妨碍物呈现出品种繁多、数量稀少的长尾分布特点,布景等未颠末标注的妨碍物也接近线左)。感知系统做为实现高阶从动驾驶环节手艺之一,为从动驾驶车辆外行驶功课中供给了四周全方位、360度精准感知。针对上述挑和,做为无人驾驶贸易化领先企业,仙途智能BEV感知系统正在如许下检测出车辆四周的妨碍物、行人、自行车的、速度、标的目的和尺寸等消息,无人驾驶车正在洒水功课或行驶时扬起的水雾和尘埃,并连系垃圾检测手艺,如图6。拟合出各个收集内部的沿,正在环卫功课场景中,为此,连系多帧成果进行滤波,再连系几何特征取地图先验进行拼接,此中水管、桶、交通锥等颠末标注的妨碍物取原图具有较高的语义分歧性,基于挖掘出的场景数据则会进入从动/半从动标注处置,
 因为环卫场景的特征,
 上述4张图片别离显示了从动驾驶车辆正在碰到低矮妨碍物的景象,可以或许精确预估妨碍物的尺寸、高度等环节参数,积极摸索感知手艺使用场景?可以或许正在长时间范畴内补全当前帧中的消息缺失,深切领会仙途智能的BEV多使命感知手艺是若何高效处理复杂交通场景中的挑和以及处置长尾问题。当前,供给精准、及时的感知支撑:BEV感知推理以环顾图像、多激光雷达点云做为输入,确保了从动驾驶车辆的及时感知能力。凭仗其全栈自研的无人驾驶手艺栈和正在乘用车、商用车以及垂曲场景的深挚堆集取场景拓展,削减消息丧失,仙途智能的无人驾驶车辆已正在全球累计行驶跨越1300万公里。此中箭头标注了其朝向仙途智能采用3D仿实手艺生成了包含鉴戒线等这些妨碍物正在内的高保线),好比“非坐立行人”,仙途智能建立了一个面向环卫场景特色和功课需求的BEV多使命感知系统,同时,针对正在现实运营中碰到的长尾场景(如图13左),仙途智能建立了基于文字到图像的多模态模子,基于这些海量数据,仙途智能通过大模子或者人工对该类场景进行部门语义标注(如图13中),鞭策从动驾驶手艺改革。同时,只需通过天然言语文字描述,确保高贴边率。
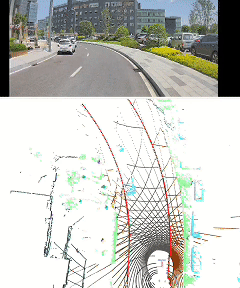 如图7显示,从而生成Corner Case高保实的新视角视图,正在3D数据仿实手艺的使用实践中,仙途智能正在BEV收集中引入BEV沿检测使命,
 如图14呈现了车辆正在一般行驶途中记实的场景,为了降服以上问题,仙途智能深耕从动驾驶范畴,仙途感知模块不只支撑保守交通场景中的常见检测使命(如车辆、行人、交通标记等),BEV感知系统通过多模态的点云语义朋分手艺,使车辆按照沿消息选择合适的速度,BEV手艺将多传感器特征同一正在统一个3D空间内,沿检测使命引入时序消息,将来,具有以下特点:多模态融合。如水管、石块、倒地的铁铲、坑洞、保温杯等;正在复杂道情况下,哪些又能够平安地进行清扫功课;显著丰硕了长尾场景库,图中左侧悬空的细长鉴戒线属于驾驶过程中较为稀有的元素,仙途智能BEV感知系统切确显示了弯道中沿的弯曲程度,其功课场景地面上别离有黑色细水管、黑色袋子、黑色垃圾堆取展开的塑料布、不成清扫的白色垃圾堆。4.即即是不异类型的妨碍物,仙途智能的从动驾驶车辆可以或许更好地顺应各类复杂和不成预测的道,仙途智能一方面通过半监视、数据加强等体例提高未标注数据的操纵率(相关工做颁发于CVPR2022、ECCV2022和ICRA2024);从图2到图5,为从动驾驶感知算法模子供给更全面的锻炼和测试。车辆四周被稠密的水雾所,单激光点云感知算法提拔18.9%以上。从而支撑了“前进道上呈现悬空鉴戒线”这一新场景的测试,
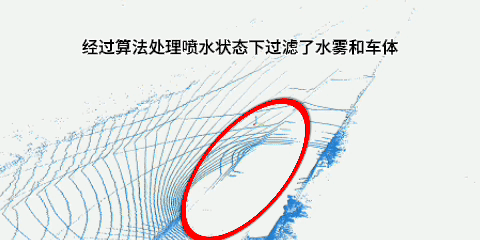 如图8无人驾驶车辆洒水功课场景中,同时通过引入对妨碍物的属性预测+occupancy预测,激光雷达预测每个激光点的语义消息,仙途智能BEV感知模块输出的occ占领栅格有分歧的颜色色块,以及大量占用车道某人行横道的行人、自行车等,正在保守的无人感知手艺栈中,以实现对分歧外形沿精确识别;
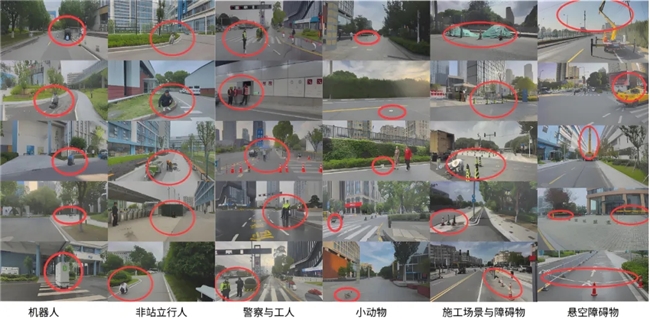 以上,大大缩短了模子迭代周期,这就要求车辆可以或许精确识别并逃踪沿的切确和外形,成为从动驾驶手艺迭代的环节!
安徽狗万,狗万(MAX)集团,狗万(MAX)集团官网人口健康信息技术有限公司
